绕过模拟 CPU:D3D/OpenGL API 转发与 x87 快速路径
2026 年 10 月 12 日 · 模拟器 · Webulator · WebGL · Windows XP
上一篇讲了我怎么在 v86 里加了一块 VMware SVGA II 显卡,用 WebGL2 执行 XP 驱动发来的 SVGA3D 命令。显卡这一侧做完后,OpenArena 能正确地画出来,但只有 13 fps,而 profile 显示 GPU 这一侧已经不是瓶颈了。
这篇讲后面的两件事:把 Direct3D 和 OpenGL 调用从客户机里直接”转发”出来,不再让图形驱动在模拟 CPU 上跑;以及给 v86 的 x87 浮点运算加一条快速路径。所有数字来自开发笔记、提交记录和截图,测试环境是 Apple M2 上的 headless Chromium,分辨率 640×480。
和上一篇一样:带 3D 的版本只在 feat/demo-3d 分支上,公开 demo 还没有它。
起点:Warcraft III 和一颗 300 MHz 的 CPU
这轮工作最初的目标是在浏览器里的 XP 上跑 Warcraft III。v86 上的 XP 忙时大约是 250 到 280 MIPS,相当于一颗 300 到 500 MHz 的 Pentium II 或 III。Warcraft III 的最低配置是 Pentium III 400,正好卡在线上。我当时在笔记里写的判断是:桌面没问题,重的游戏场景可能不行;这一点和 3D 翻译的质量一起,是这个目标最大的风险。
所以模拟 CPU 的每一个周期都很贵。而走 VMware 驱动这条路,客户机里要跑的东西很多:
- VMware 的 XP 驱动是 DDI 7 的 HAL,顶点在客户机里就变换好了,变换和光照由客户机里的 Direct3D 运行时算。
- OpenGL 程序要经过 VMware 的 Mesa 驱动(
vmwogl32.dll),Mesa 在客户机里把 GL 调用翻译成 SVGA3D 命令。 - Direct3D 8 和 9 程序还要多一层 WineD3D,先翻译成 OpenGL,再交给 Mesa。
OpenArena 的 profile 很直白:按模块统计客户机用户态的 EIP 采样,Mesa 驱动 2071 次,游戏本身 1605 次,系统 DLL 391 次。驱动吃掉的模拟 CPU 时间和游戏差不多。
思路:换掉客户机里的 d3d9.dll 和 opengl32.dll
既然显卡是我自己模拟的,SVGA3D 命令也是我自己执行的,那就没必要让客户机里的驱动去生成这些命令。我写了两个用户态的运行时:
d3d9.dll(d3d9fwd.c,约 2200 行):一个 Direct3D 9 运行时。opengl32.dll(glfwd.c,约 2000 行):一个 OpenGL 1.x 运行时。
用法是把 DLL 放到应用程序的 exe 旁边。应用调用 Direct3D 或 OpenGL 时,这两个 DLL 在应用自己的进程里把调用直接写成 SVGA3D 命令,攒在一块缓冲区里,然后用一条指令交给模拟器:
__asm__ volatile("outl %0, %w1" : : "a"(v), "Nd"(0x5680) : "memory");eax 里放的是一个小结构体的地址,里面有命令缓冲区的地址和长度。模拟器在执行这条 out 指令的过程中,就把这批命令交给已有的 WebGL2 渲染器跑完了。命令就是 SVGA3D 命令,和 VMware 驱动通过 FIFO 发的一样(只多了几条自定义的,比如日志),所以两条路共用同一个渲染器。
为了让这件事成立,v86 那边要改三个地方:
- 用户态能访问这个端口。 普通应用在 ring 3,执行
out会触发保护异常。我在 v86 的 I/O 权限检查里给 0x5680 开了个口子,做法和 VMware 的 backdoor 端口一样。 - 数据不拷贝。 顶点、索引和纹理数据不复制进命令缓冲区,命令里只写它们在应用里的线性地址(我定义了一个伪 GMR
0xFFFFFFFD表示”这是线性地址”),模拟器通过客户机的页表去读。为此加了一个无副作用的地址翻译:不触发缺页,不改 accessed/dirty 位。 - 模拟器写客户机内存时让 JIT 失效。 回读像素这种操作会写客户机内存,对应页上已编译的代码要丢掉。
还有一个细节:如果某一页模拟器读写不了(比如它此刻不在内存里),模拟器不能替客户机处理缺页。这时它会停下来,告诉客户机出问题的地址和已经处理了多少字节;客户机这边的 DLL 去读(必要时写)一下那个地址,让 Windows 把页调进来,再把剩下的命令重新提交。
渲染器这一侧也补上了之前用不到的东西:固定管线的变换和光照(world/view/projection 矩阵、8 盏灯、材质来源、顶点雾)。走 VMware 驱动时这些都由客户机算好了,现在要宿主来算。
Direct3D:先拿最简单的测试量
第一个测试程序是 d3d9spin:一个转动的立方体,每帧一次绘制。
| 测试 | WineD3D + Mesa | 转发 |
|---|---|---|
| d3d9spin(每帧一次绘制) | 约 800 次 present/秒 | 约 23,000 次/秒 |
| d3d8spin | 无数据 | 约 19,000 次/秒 |
Direct3D 8 没有单独写,用的是 crosire 的 d3d8to9:它把 D3D8 调用转成 D3D9,正好落到我的 d3d9.dll 上。我只给它打了一个小补丁,去掉缺少 d3dx9_43.dll 时弹的对话框。
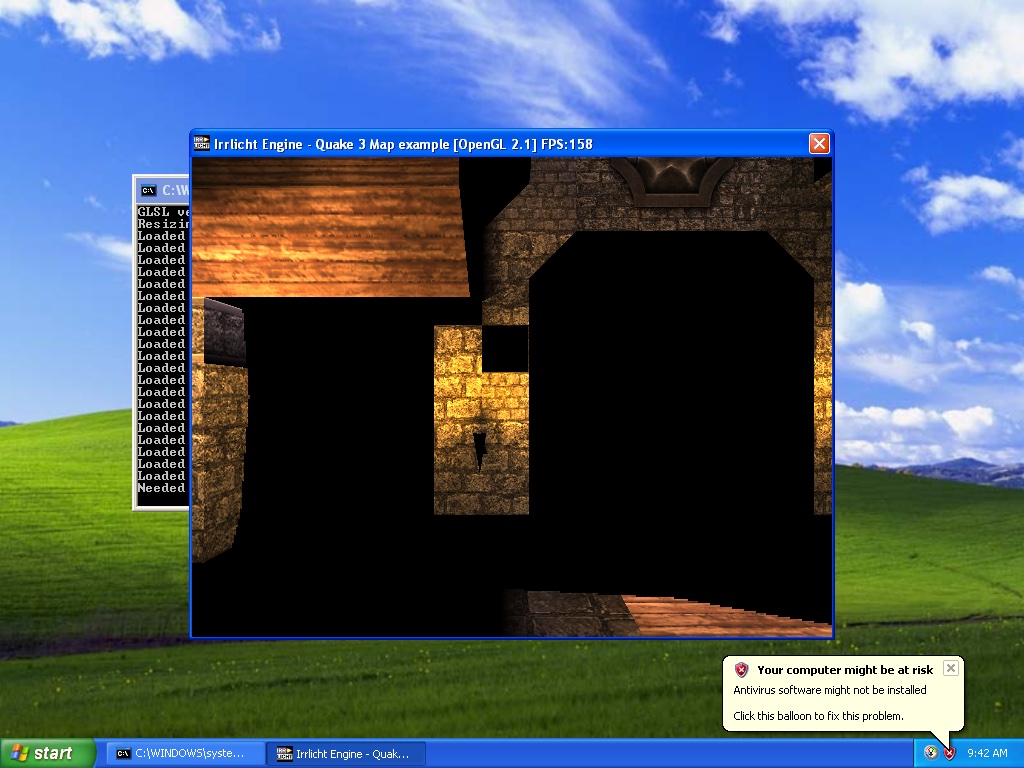
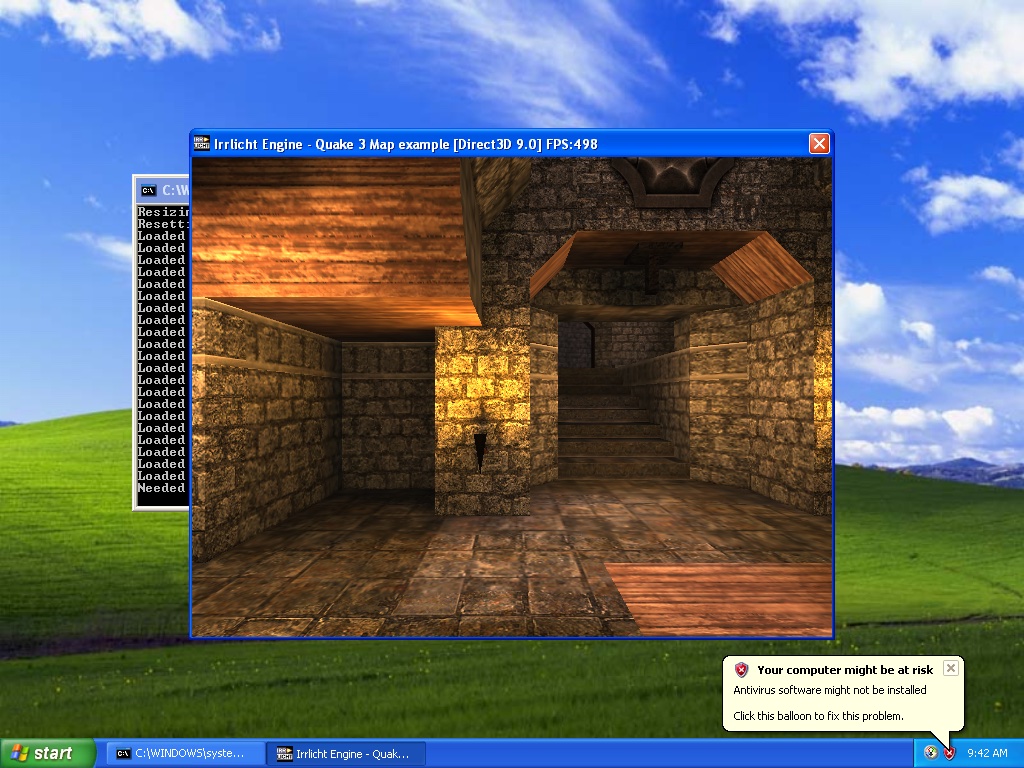
再看一个真实一点的场景:Irrlicht 1.8.5 自带的 02.Quake3Map 示例。Mesa 驱动下它跑 158 FPS,而且画面上有大块黑色;转发的 Direct3D 9 第一版跑到 389 FPS,画面正确;到 OpenGL 转发也做完的时候,这个数字是 498 FPS。
OpenGL:状态机翻译成 D3D 风格的命令
OpenGL 这边麻烦一些,因为 OpenGL 是一个状态机,而 SVGA3D 是 Direct3D 的模型。glfwd.c 的做法是:在 DLL 里跟踪所有 GL 状态,每次绘制前把变化的部分翻译成 SVGA3D 的渲染状态和纹理状态,固定管线的计算交给渲染器。
它实现了 OpenGL 1.1 的全部 336 个导出函数(每个都必须存在,而且栈大小要对,存根是从 mingw-w64 的 GL/gl.h 生成的),加上 WGL、多重纹理、texture_env_combine、compiled_vertex_array、顶点缓冲对象、S3TC 和 BGRA 顶点数组。几个约定:
- 宿主按 Direct3D 的方向渲染(第 0 行在顶部),裁剪空间 z 在 [0, w]。
- OpenGL 的矩阵原样传过去:列主序的 OpenGL 矩阵和行向量约定的 Direct3D 矩阵在内存里是同一个布局,只需要把投影矩阵的 z 重新映射一下。
- 视口、裁剪矩形和回读都要翻转 y。
顶点数据和 D3D 一样尽量不拷贝:客户端数组和索引由宿主直接从应用内存里读,每次绘制一次 hypercall。只有 glBegin/glEnd 这种逐个顶点提交的方式,才先攒进 DLL 里的一块缓冲区。
为了验证顶点数组的各种组合,我写了一个小程序 glarrays:12 个格子,每格用一种不同的顶点数组设置画同一个四边形(分开的数组、交错数组、BGRA 颜色、16 位和 8 位索引、带偏移的索引、两个纹理单元、glBegin/glEnd、缓冲对象等)。每一格都应该是左上红、右上绿、右下蓝、左下白。
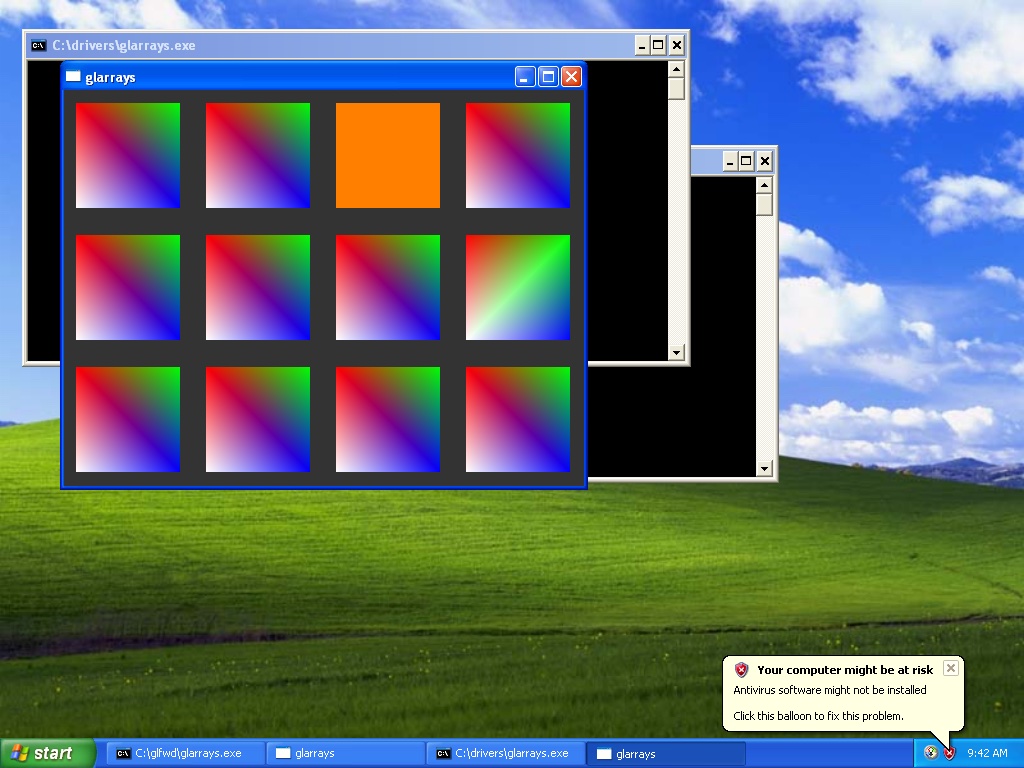
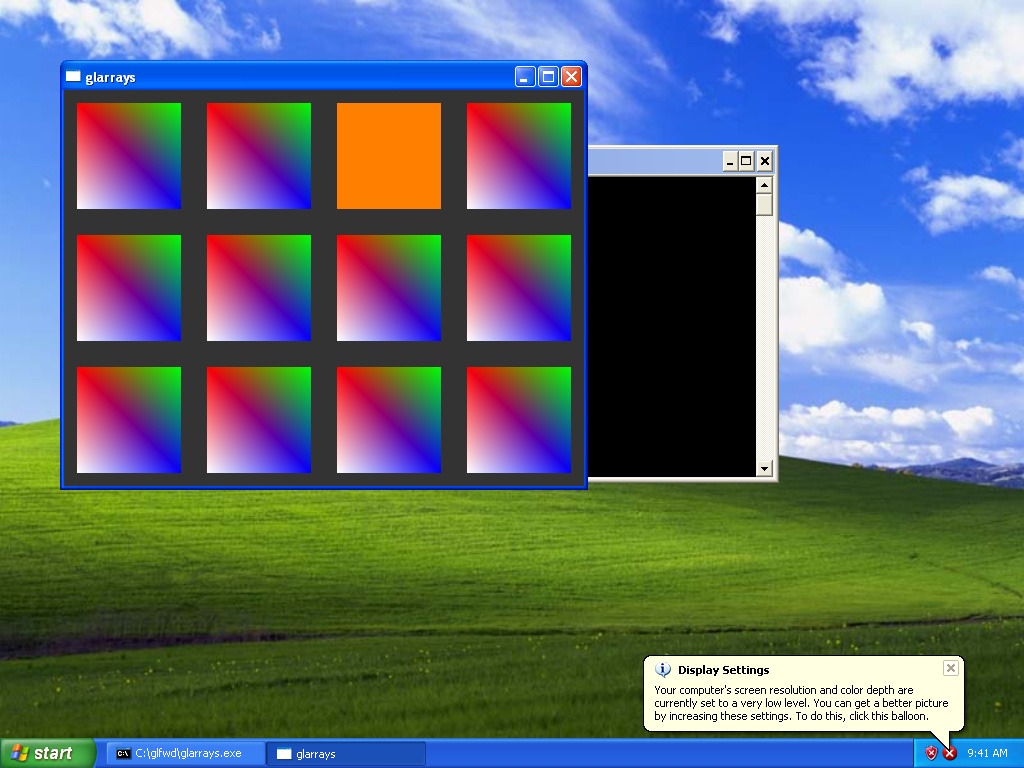
12 格在两边都画出来了,四个角的颜色也一致。唯一能看出区别的是第 8 格(glBegin/glEnd 画的 GL_QUADS):Mesa 那边的颜色过渡沿着另一条对角线。四边形拆成两个三角形时选哪条对角线,OpenGL 本来就没有规定,所以我没有把它当成错误。
路上的两个渲染器 bug
接上 OpenArena 之后,转发版一开始只有 2 fps。原因是:我把流式写入的小块顶点数据放在一个大的 GL 缓冲里,每次更新其中一小段;但如果还有排队的绘制在用这个缓冲,浏览器会把整个缓冲拷贝一份。改成每一小块用自己的 GL 缓冲后,从 2 fps 变成了 15 fps。
另一个是偶尔出现画了一半的帧。之前 present 是在下一次屏幕刷新时才从后缓冲回读,那时应用常常已经在同一个后缓冲上开始画下一帧了。现在 present 时立刻拷贝到一张前缓冲纹理上。
x87 快速路径
x87 快速路径在时间上其实比转发早一步做。上一篇提到的那次 profile 里,除了客户机的 JIT 代码,第二大的一块是 x87 SoftFloat,占 worker 时间的 30%。
v86 用 80 位的 SoftFloat 软件实现来算每一条 x87 运算。但很多 Windows 程序并不用 80 位精度:x87 有一个精度控制字段,MSVC 和 Windows 默认是 53 位,Direct3D 默认会设成 24 位。
快速路径的条件是:舍入模式为”就近舍入”,精度控制为 53 位或 24 位,两个操作数都能精确表示为 double,并且结果是正规数。这时:
- 53 位精度的舍入就是 IEEE double 的舍入,所以直接用原生 f64 算加减乘除,结果和 SoftFloat 一样。
- 24 位精度时,先用 double 算再舍入到 float,结果也是正确舍入的单精度结果,因为 53 ≥ 2×24+2。
- 其他情况(别的舍入模式、80 位精度、非正规数、无穷、NaN、上溢下溢)全部退回 SoftFloat。
浮点数的加载和存储(f32、f64 和 80 位之间的转换)也走同样的思路。需要说明的是,快速路径不会设置”不精确”(inexact)状态标志。我用 1.68 亿组随机输入、覆盖所有精度和舍入模式组合,和 SoftFloat 对比,结果逐位一致。
效果在 OpenArena 上并不大:timedemo 从 13.0 fps 到 14.0 fps。原因是 OpenArena 是用 MinGW 编译的,运行在 80 位精度下,算术本身吃不到快速路径,主要是浮点加载和存储变快了。
同一时间我还试过让 FIFO 由硬件定时器轮询,结果是 12.6 fps,比不改还慢,就撤掉了。
结果
| 测试(640×480) | VMware 的 Mesa 驱动 | 转发 |
|---|---|---|
| d3d9spin | 约 800 次 present/秒(WineD3D + Mesa) | 约 23,000 次/秒 |
Irrlicht 02.Quake3Map,OpenGL | 158 FPS,有黑块 | 329 FPS,正确 |
Irrlicht 02.Quake3Map,Direct3D 9 | 无数据 | 498 FPS,正确 |
OpenArena demo088-test1 | 14.0 fps | 16.9 fps |
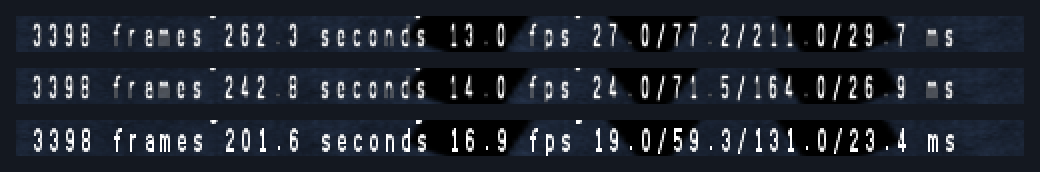
OpenArena 同一段 3398 帧的录像:
| 版本 | 总时间 | 平均帧率 | 每帧耗时 最小/平均/最大 |
|---|---|---|---|
| Mesa 驱动 | 262.3 秒 | 13.0 fps | 27.0 / 77.2 / 211.0 ms |
| Mesa 驱动 + x87 快速路径 | 242.8 秒 | 14.0 fps | 24.0 / 71.5 / 164.0 ms |
| 转发 + x87 快速路径 | 201.6 秒 | 16.9 fps | 19.0 / 59.3 / 131.0 ms |
Irrlicht 示例的提升是成倍的,OpenArena 只从 14.0 到 16.9 fps。按笔记里的结论,OpenArena 现在被模拟 CPU 限制着,具体是它自己的 x87 运算:MinGW 编译、80 位精度,正好是快速路径帮不上的部分。
Warcraft III 呢
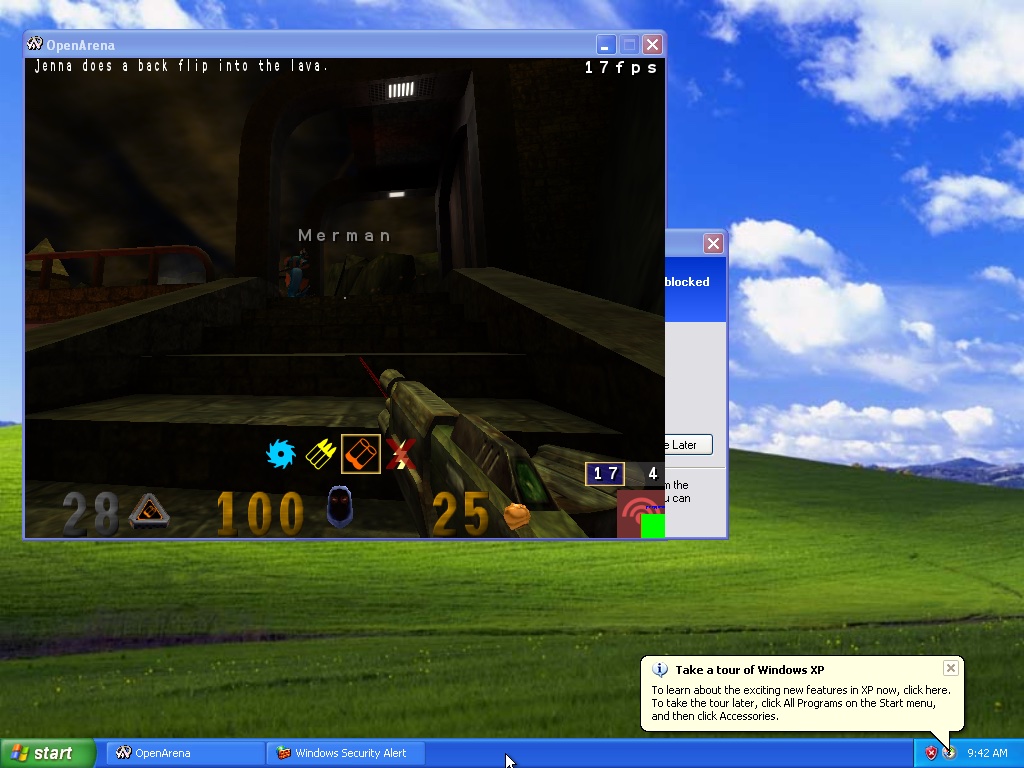
这几天的记录里没有 Warcraft III 跑起来的结果。Warcraft III 是固定管线的 Direct3D 8 游戏,按设计它会走 d3d8to9 加转发的 d3d9.dll 这条路,但我没有它的测试数据,就不在这里猜了。最后放进 demo 的是 OpenArena:恢复 XP 桌面快照后在客户机里启动游戏,渲染走转发的 OpenGL,帧率显示在游戏窗口右上角。这个 demo 目前也只在 feat/demo-3d 分支上。
还缺什么
d3d9.dll:没有立方体纹理和体积纹理,没有ProcessVertices、patch 和隐式交换链以外的交换链,着色器能力报的是 SM 2.0。带着色器的 D3D8 程序需要旁边有d3dx9_43.dll,因为 d3d8to9 要用它来汇编着色器。opengl32.dll:OpenGL 1.5,没有 GLSL;没有 texgen、纹理矩阵、裁剪平面、显示列表(编译的列表直接丢弃)、glCopyTexImage、立方体贴图和帧缓冲对象。- 3D 画面直接画进显存里窗口所在的区域,盖在上面的窗口会被覆盖。