只给一个样例,AI 能在图纸上找全符号吗?
2026 年 10 月 19 日 · AI · 计算机视觉 · 工程图纸 · 少样本学习
为什么做这件事
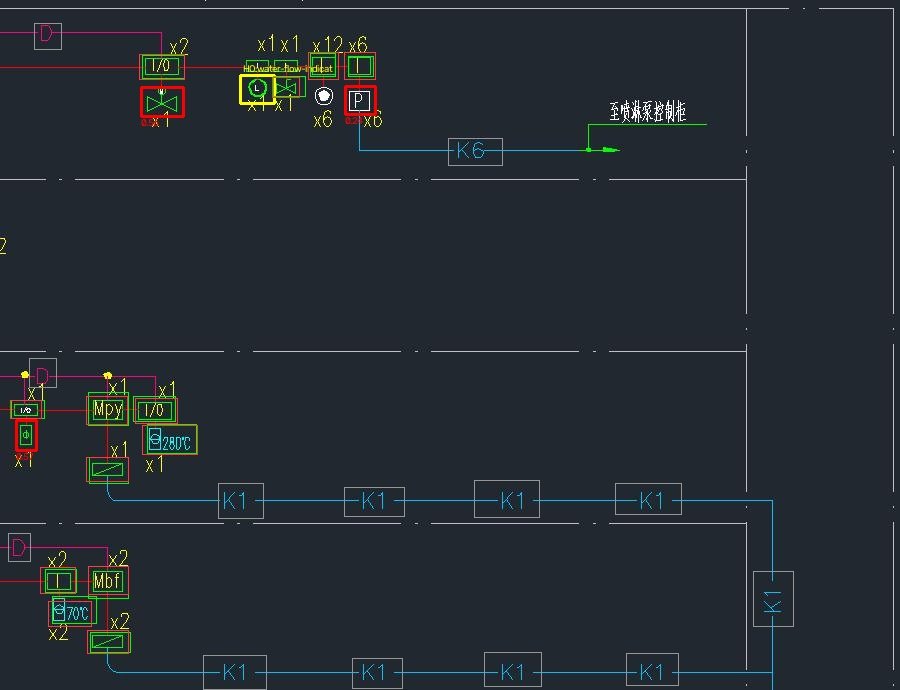
我一直认为,AI 要理解物理世界,读懂图纸是绕不开的一步。一栋楼在建成之前,几乎所有信息都写在图纸上:哪里有设备,接到哪条线,属于哪个系统。而读图的第一步,就是把图上的符号认出来、数清楚。
这件事用全监督目标检测能做好,前提是每类符号都有足够多的标注。现实里的问题是:不同项目、不同设计院的符号画法不一样,新项目里总会冒出没见过的符号,没人愿意为每个项目重新标几百个框。所以我想知道的是:每类只给一个样例,能做到什么程度?给五个呢?差距到底在哪?
下面是两天实验(2026-10-18 到 10-19)的记录,所有数字都来自实验日志,硬件是一台 Apple M2、16 GB 内存的笔记本。
数据和评测口径
数据用的是 Roboflow Universe 上公开的 Firefighting Device Detection(v6 导出,作者为一位 Roboflow 用户,许可证 CC BY-NC-SA 4.0)。它是消防报警系统图的截图,148 张图,41 类,3785 个标注框。本文中的图纸截图都来自这个数据集。
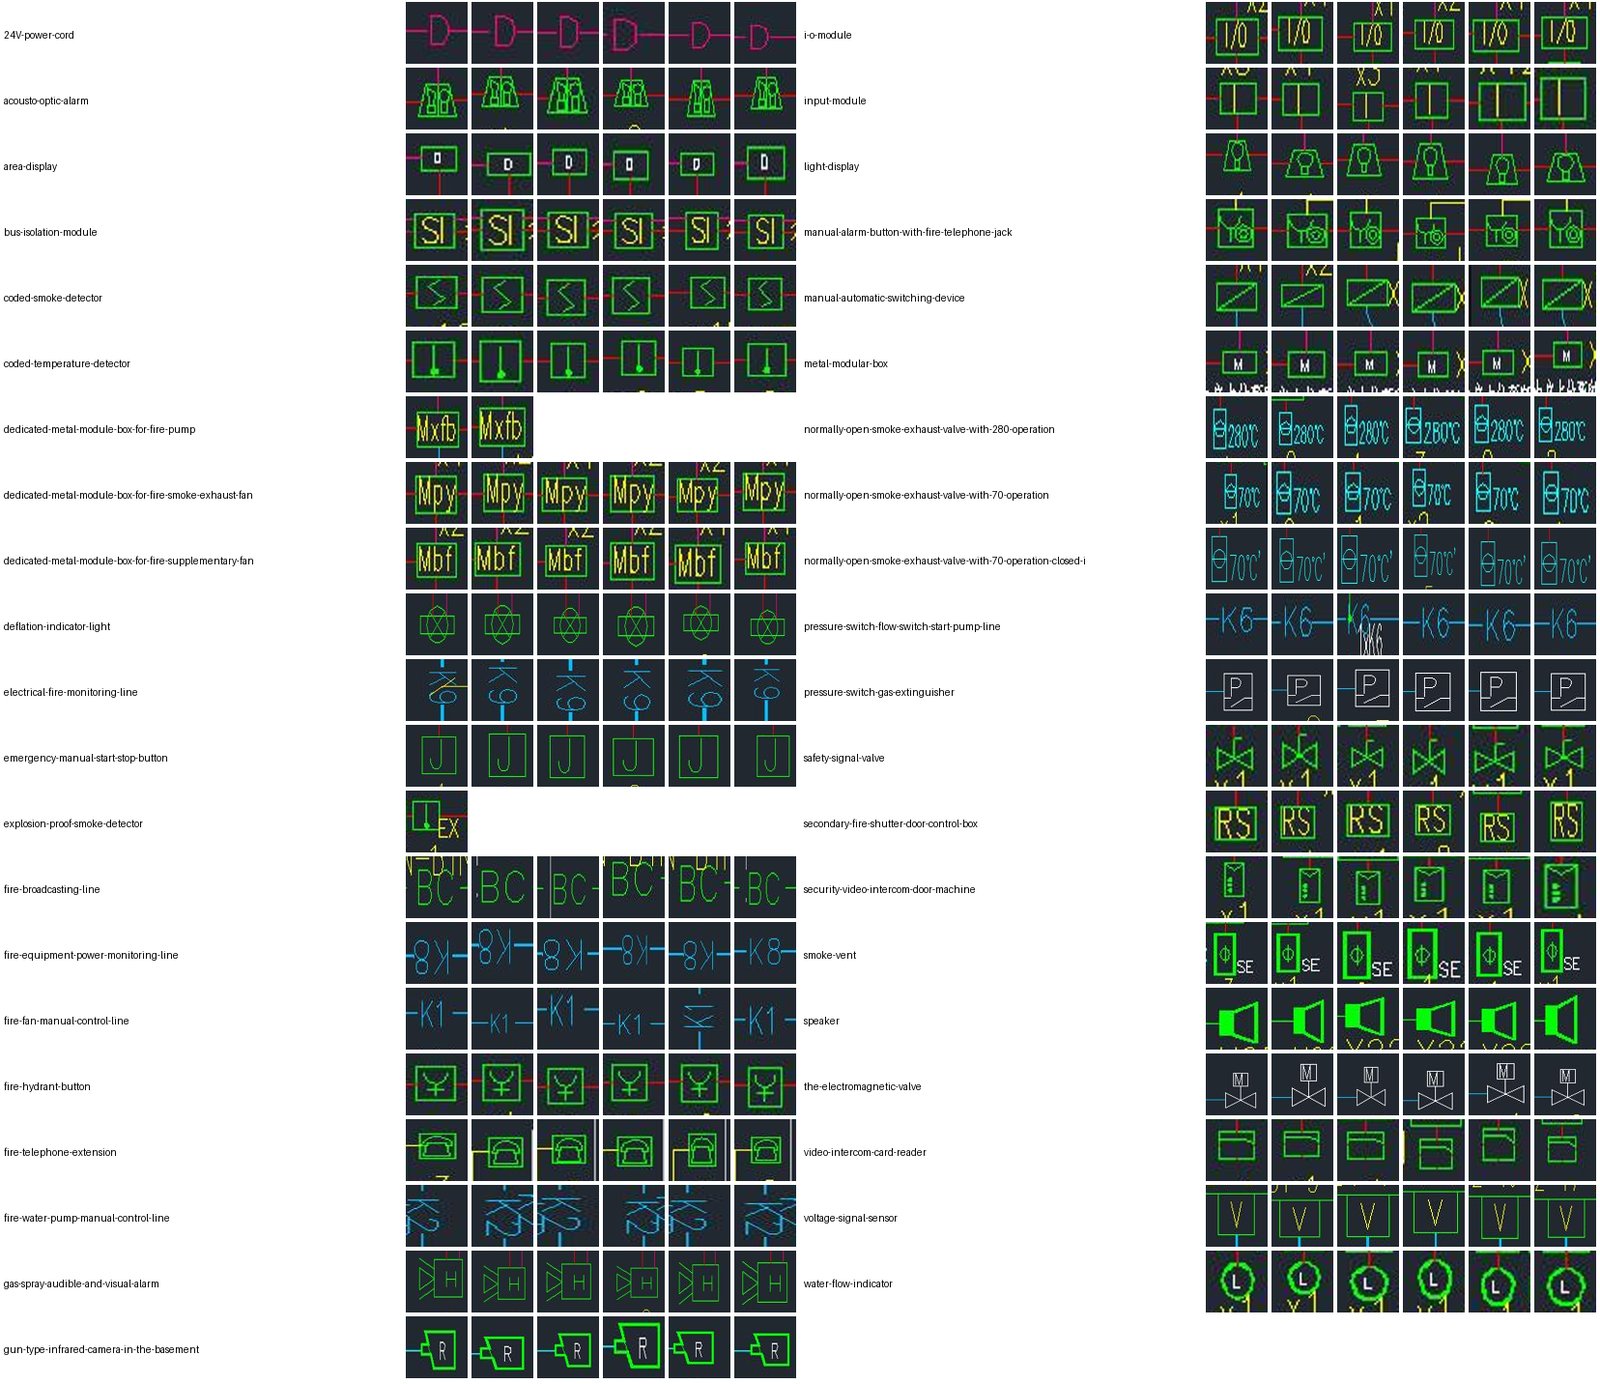
这里的“符号”其实分两种:
- 图形符号:方框、阀门、喇叭、摄像机之类,有些框里带字,比如 Mpy、Mbf、280°C。
- 线上文字标记:导线上的 D、K1、K8、BC 等,用来标明这是哪条线。D 代表 24V 电源线,画成导线上的一个鼓包,在测试集里占了 38%。
评测时我刻意把难度放在“跨图纸”上:
- 按原图分组切分(文件名前两段相同的视为同一张原图,共 26 组)。测试集 6 组、30 张图、824 个框。
- 样例必须来自训练或验证组的图,不能和测试图同源。
- 8 个图形类从头到尾不参与任何训练,作为“新类”。
- 主要指标是 IoU 0.5 下的 F1,1-shot 和 5-shot 各跑 5 个随机种子取平均。
整体思路
我把问题拆成“这里有没有符号”和“这是哪个符号”两件事:
- 类无关检测器:只回答“这是不是一个符号”,不管类别。
- OCR:专门找导线上的文字标记。
- 合并:把框内文字、旁边的计数(x2 之类)归到对应符号上。
- 分类:拿候选框去和每类的样例比相似度,取最像的一类。
- 拒识:分数不够高或者前两名太接近,就不输出。
第一步:类无关检测器
我训练了一个单类 YOLO11s:所有已见类都标成“symbol”,8 个留出类在训练图里用周围背景色涂掉。训练一共用了 54.2 分钟(其中 14.3 分钟是一次因内存交换而中止的运行)。
测试集上,置信度 0.1、IoU 0.5:
- 已见类召回 343/343(100%)。
- 未见过的新形状召回 37/42(88.1%)。
- 精确率 95.4%(按原始标注算)。
不训练的规则基线(去长直线、连通域、尺寸过滤)在同样口径下精确率只有 41.2%,AP50 0.665;YOLO 是 0.992。
漏掉的 5 个新形状全是同一类:水流指示器,一个粗圆环里写个 L,0/5。它是唯一一个外轮廓为圆形的留出类,训练集里几乎没有这种外形。我猜模型学到了“圆形就是背景”,但这一点没有做对照实验验证。
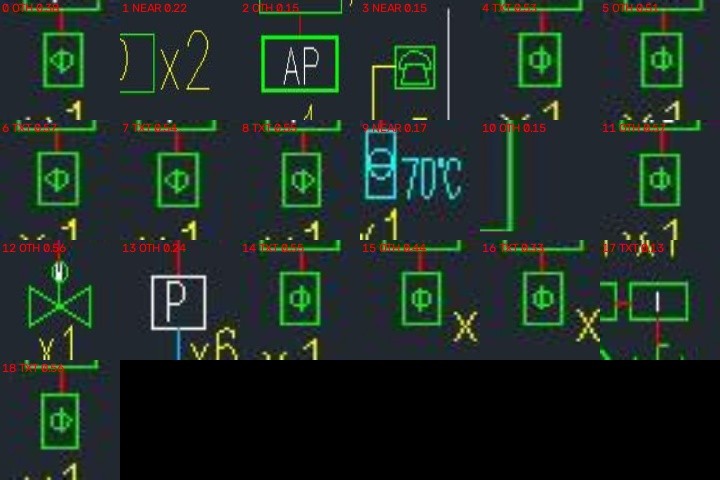
更有意思的是误检。我把 19 个误检逐个看了一遍,其中 15 个其实是数据集漏标的真符号(大多是带 Φ 的方框,还有 AP、P 方框和阀门)。按“是不是图形符号”算,精确率约 99%(412/416)。这也提醒我:后面所有数字都受标注质量的上限约束。
第二步:OCR 和“去直线”
导线上的 D、K1 这类单字,现成的 OCR 几乎读不出来,因为导线从字中间穿过。我试了 RapidOCR(PP-OCR 系列)、Apple Vision 和 Tesseract。
效果最大的一招是预处理:用长的横向和竖向开运算找出导线和框线,从二值图里扣掉,再交给 OCR。在 1984 个线上标记上(RapidOCR,0°/90°/270° 三个方向):
| 预处理 | 定位召回 | 读对(strict) |
|---|---|---|
| 原图 | 11.1% | 8.5% |
| 去直线 | 96.5% | 57.9% |
定位召回提高了接近 9 倍。Apple Vision 也一样,从 6.5% 升到 28.0%。竖排文字靠把整图旋转 90° 和 270° 再跑一遍解决:竖排 K2 从 0/31 变成 30/31。
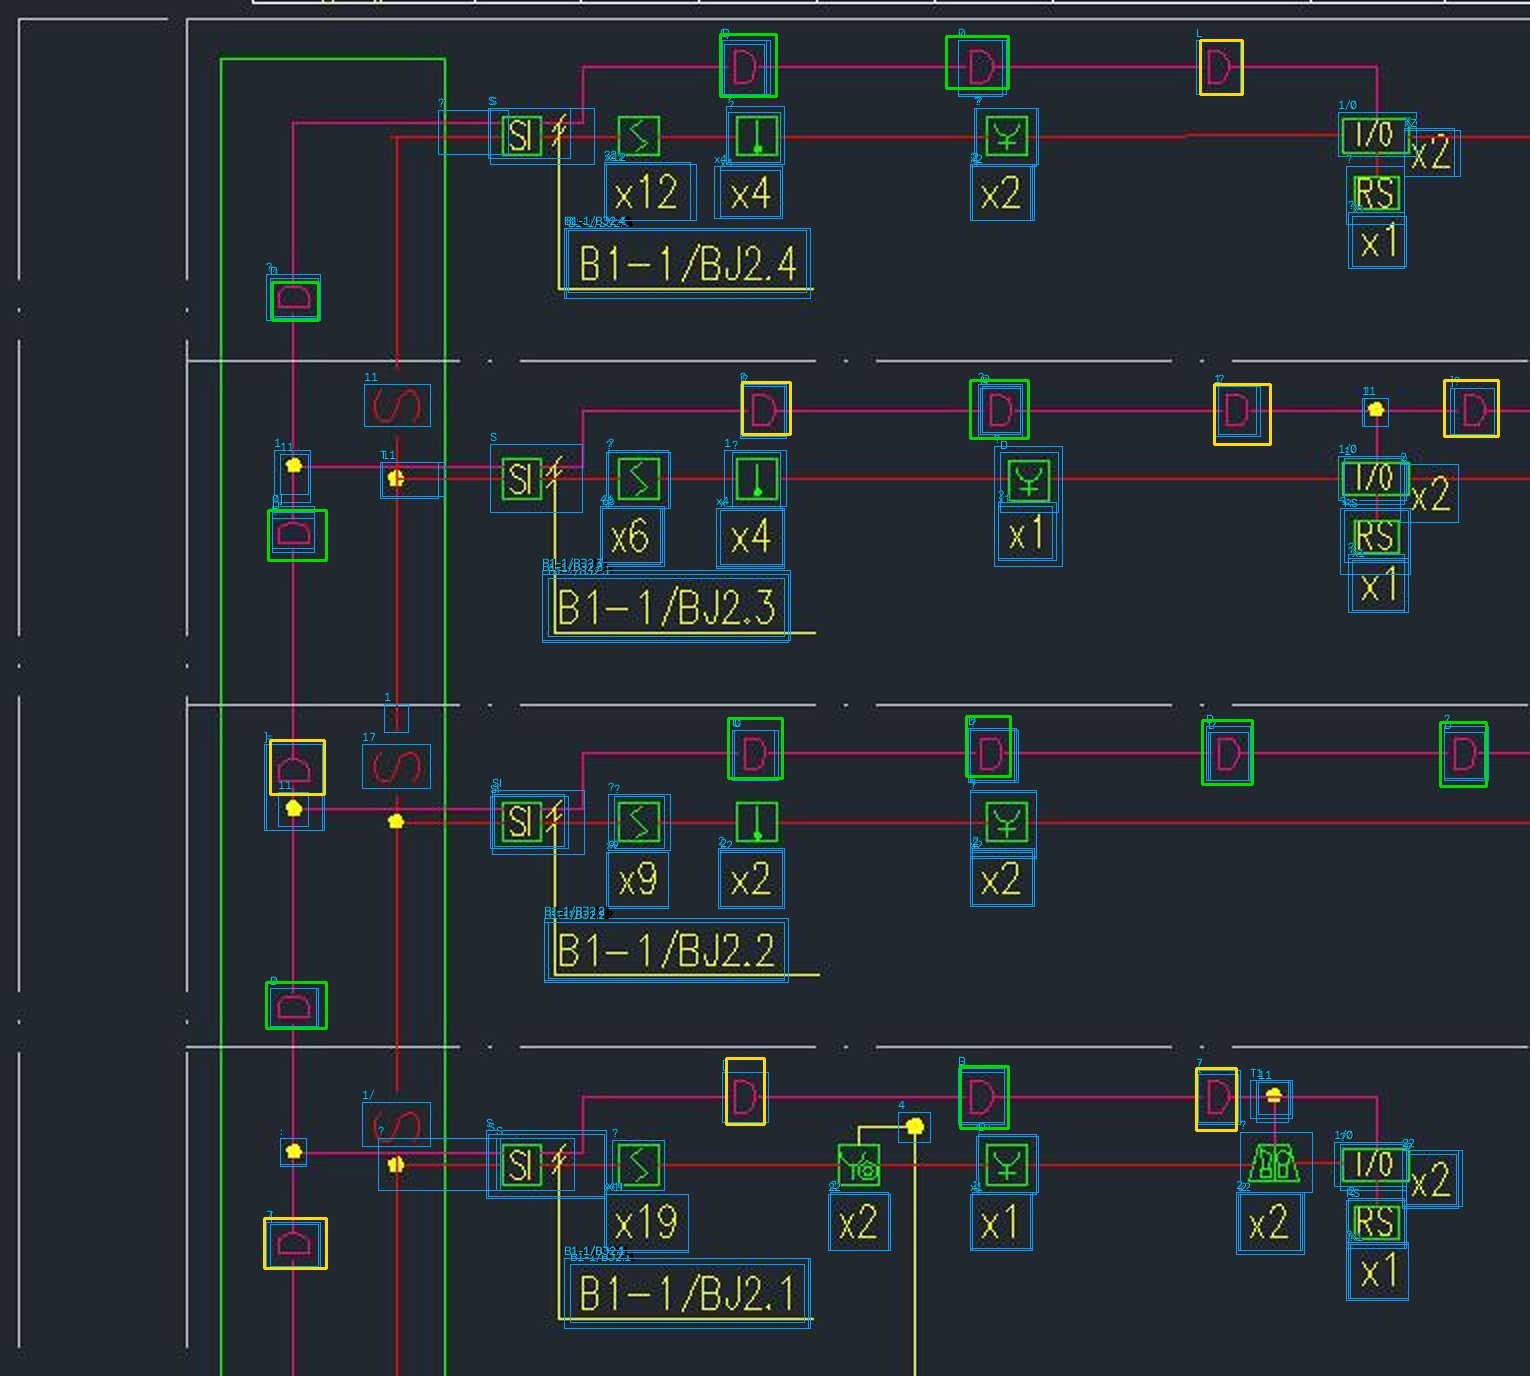
但去直线也有代价。K1、K2、K6、K8、K9、BC 六类合计读对 94.7%(568/600),而 D 能框出 95%,只读对 41.9%:去直线把 D 的那条竖边也擦掉了,剩下的弧形被读成 C、口、0、[。
第三步:免训练的 one-shot 分类
先单独测分类:给定真值框,每类 1 个或 5 个样例,看能不能分对。为了让逐对计算的方法也跑得完,所有方法用同一批 877 个查询(每类最多 30 个,micro 按全量类别频数重新加权)。
| 方法 | 1-shot micro | 1-shot macro | 5-shot micro | 5-shot macro |
|---|---|---|---|---|
| NCC 模板匹配(笔画) | 50.3 | 77.3 | 87.9 | 94.4 |
| NCC 模板匹配(彩色) | 64.4 | 73.1 | 89.0 | 90.7 |
| DINOv2-small CLS | 59.5 | 79.5 | 86.3 | 89.8 |
| DINOv2-base CLS | 61.4 | 80.5 | 88.8 | 91.8 |
| DINOv2-small patch 匹配 | 63.0 | 81.2 | 87.6 | 92.2 |
| CLIP ViT-B/16 图像嵌入 | 65.1 | 81.7 | 91.7 | 93.8 |
| CLIP ViT-B/16 patch 匹配 | 68.4 | 86.4 | 92.8 | 95.2 |
| CLIP patch 匹配 + 旋转样例 | 82.4 | 85.9 | 95.8 | 94.5 |
(5 个种子的均值,单位 %,标准差见原始日志。)
几点观察:
- CLIP 比 DINOv2 好,而且 DINOv2-base 相对 small 没有提升。这批符号很多靠字区分(Mpy、Mbf、Mxfb),我猜 CLIP 因为见过大量图文对,对字形更敏感,但没有专门验证。用 CLIP 时,Mpy/Mbf/Mxfb 三类准确率 95% 到 100%。
- 方向是最大的坑。K1 有 128/474 个是竖排的,D 在竖线上画成拱形。样例同时存 0°/90°/270° 三份后,micro 从 68.4 升到 82.4,D 从 54% 升到 84%。代价是竖排 K9 从 74% 掉到 37%,因为旋转后的 K8 和竖排 K9 太像。对这两类来说,方向本身就是类别信息。
- 从 1 个样例到 5 个样例,micro 普遍提升 10 个点以上,这是最便宜的改进。
- 对检测框不准的容忍度不错:框平移 ±10%、缩放 0.9 到 1.15 倍,micro 只降 1.1 点。
- 开集拒识弱:最好的 AUROC 是 0.853,保留 95% 已知类时只能拒掉约 31% 的未知类。最大相似度不是可靠的“我不认识”信号。
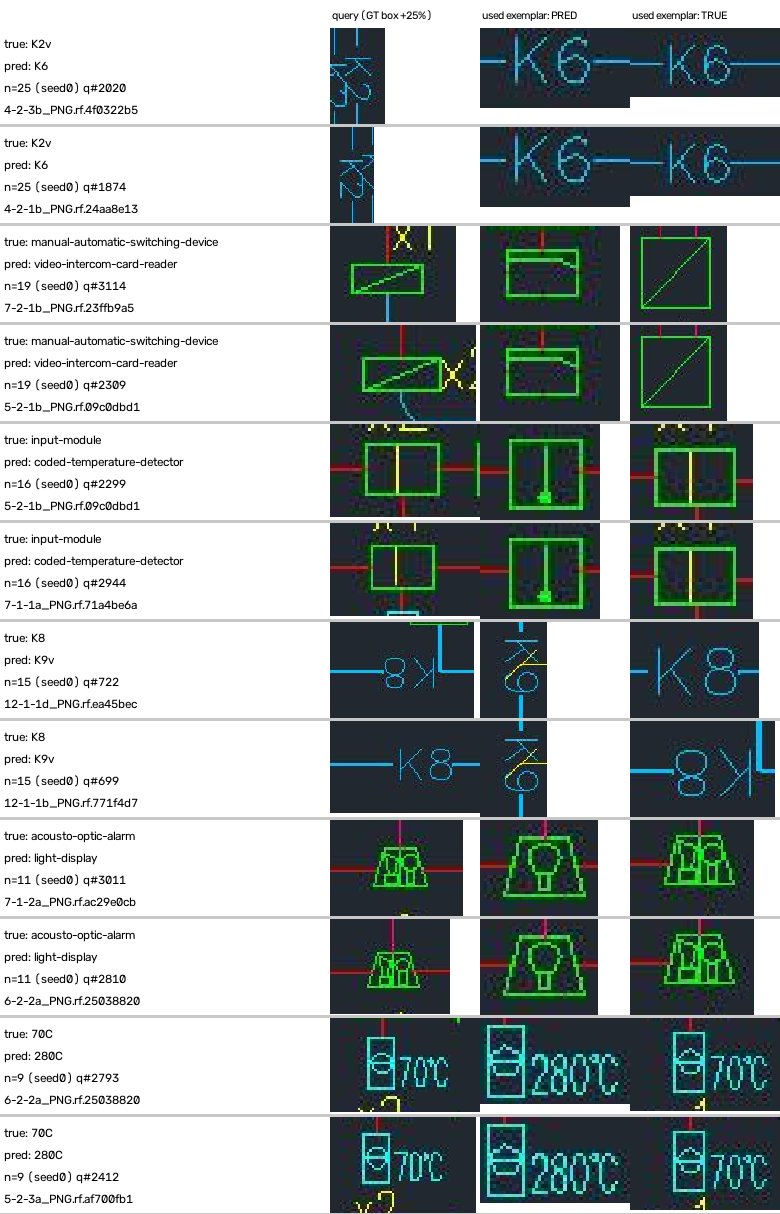
剩下的错误大多是可以理解的:同一类在不同图纸里画法不同(手自动切换装置),不同类外轮廓几乎一样(声光报警器和光显示器),70°C 和 280°C 排烟阀只差几个字而且字号不一。
第四步:端到端,分类不训练
把上面几步串起来(检测器 + 去直线 OCR + 合并规则 + CLIP patch 匹配加旋转样例 + 全局拒识阈值),参数只在验证组上调,测试集只评一次:
- 1-shot:F1 micro 80.7±4.0,macro 77.9±5.6(精确率 91.2,召回 72.5)。
- 5-shot:F1 micro 88.2±1.0,macro 90.3±1.6。
- 如果直接用真值框代替检测和 OCR(不拒识),1-shot 86.4,5-shot 98.4。也就是说,上游和拒识一起损失约 6 到 10 个点。
单张图耗时在空闲时测得 5.64 秒,大头是三方向整图 OCR(2.43 秒)。
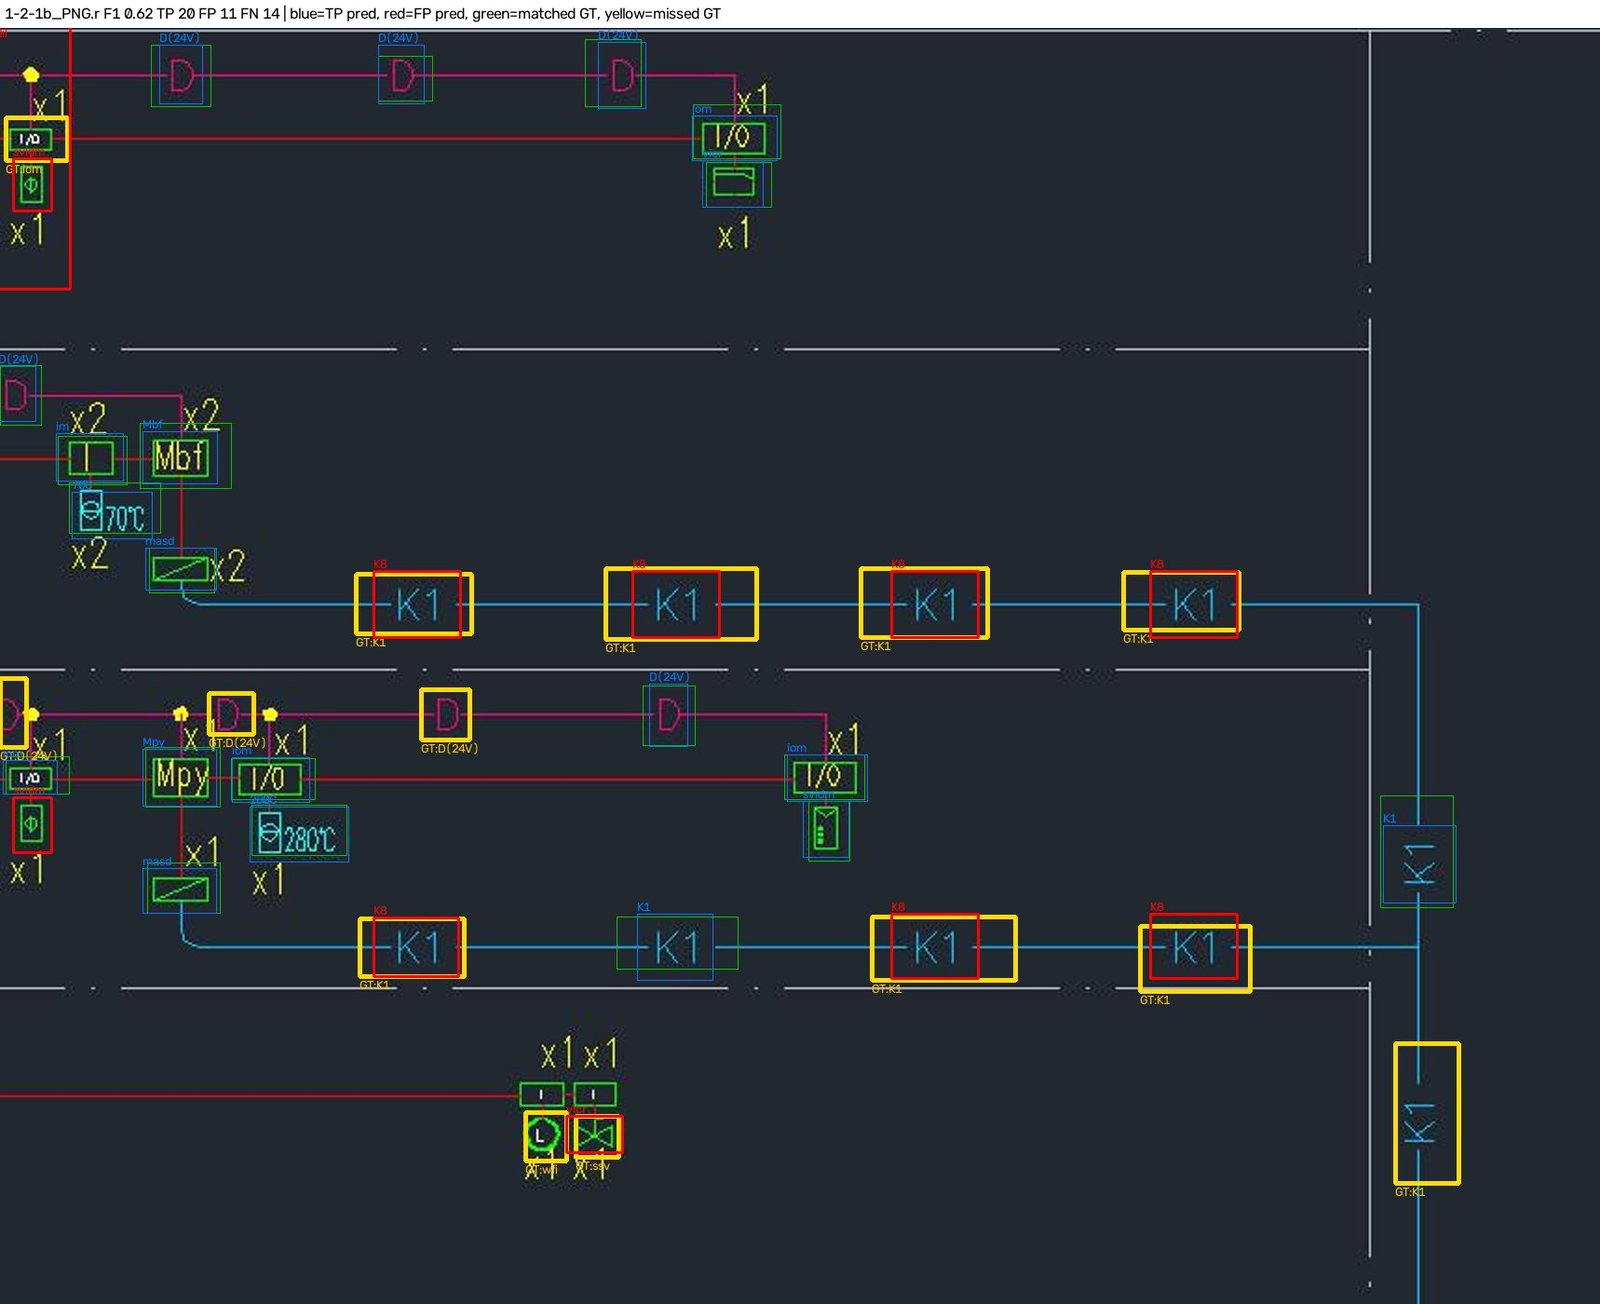
最大的单项损失还是 D。在真值框上,CLIP 把 D 排第一的比例有 90%,但 D 的相似度中位数只有 0.924,全局拒识阈值是 0.921,于是 33% 的 D 被拒掉了。上图里成排的 K1 被判成 K8,原因是测试图里的 K1 外面套了方框,而样例没有。
几个没成功的尝试,也记一下:
- 按类自适应拒识阈值:1-shot micro 从 80.7 到 81.5,但 macro 从 77.9 掉到 74.1,不采用。D 和背景文字(去直线后的 C、口)在 CLIP 特征上本来就重叠,阈值分不开。
- 用 OCR 读到的样例文字辅助分类:样例自己的 OCR 就不可靠(K1 样例读成 4K1,24V 读成“亡”),改成文本优先后验证集更差。即使让用户确认样例文字,整体也只从 80.7 到 82.0,在种子间波动范围内。
- 去掉整图 OCR 候选:1-shot 掉到 57.5。测试集里 51% 的框是文字标记,目前只有 OCR 能给出它们的候选,所以 OCR 必须保留。
第五步:加一点训练
既然瓶颈在文字标记和背景区分,我又做了两处训练,共约 72 分钟:
- 新检测器 det_v2:把文字标记也当成“符号”来检测,修掉了上一版 mosaic 增强过早关闭的问题,固定训练 80 个 epoch,58.7 分钟。
- 匹配头:冻结 CLIP 的 patch token,只训练一个 768 到 256 的线性映射,用监督对比损失,13 分钟。
这一轮的新类换成了 8 个留出图形类加上 K1(K1 作为一个没见过的文字标记),其余 32 类为基础类。测试集仍是同样的 30 张图、824 个框。
| 设置 | 训练了什么 | 1-shot F1 | 5-shot F1 |
|---|---|---|---|
| 端到端 v0 | 只有类无关检测器 | 80.7 | 88.2 |
| det_v2 + 匹配头,只用检测器候选 | 检测器 + 匹配头 | 94.3 | 95.2 |
| 全监督多类 YOLO11s(对照) | 32 类全监督 | 81.4(新类为 0) |
最好配置的分项(1-shot):基础类 97.0,新类 83.8(按类平均 90.1)。
这里有几个必须说清楚的地方:
- 94.3 不是“所有类都只见过一个样例”。基础类在训练检测器和匹配头时都见过,只有新类是真正的 one-shot。新类的 micro 分数又被 K1 主导(169 个新类框里 110 个是 K1)。
- 匹配头很快过拟合:验证集上新类准确率在第 250 步是 88.3%,到 1500 步掉到 48.3%。我是按验证集新类准确率挑的模型,所以测试集上的新类数字可能略偏乐观。
- 新检测器找全了文字标记以后,OCR 候选反而成了主要的误检来源,去掉它们后全部 F1 从 90.4 升到 94.3。
- 同样的训练数据,全监督多类 YOLO 在基础类上 F1 91.3,比“类无关检测 + 匹配”低约 6 分,主要输在精确率(86.2),而且完全不能识别新类。
和全监督模型比一比
作为上限参考,我调用了 Roboflow 上同一个项目托管的全监督模型(firefighting-device-detection/5,41 类,约 2600 个训练框)。
麻烦在于,我的 30 张测试图里有 24 张在它的训练集里。能公平比的只有双方都没见过的 6 张图(139 个框):
| 方法 | F1 micro | F1 macro |
|---|---|---|
| Roboflow 全监督(conf 0.4) | 95.9 | 98.9 |
| 我的端到端 v0.3 1-shot(分类免训练) | 81.0±4.9 | 87.1±6.2 |
| 我的端到端 v0.3 5-shot(分类免训练) | 89.6±1.2 | 94.0±2.5 |
v0.3 是端到端 v0 去掉“检测框裁图再做 OCR”这一步后的默认配置,那一步在消融里没有带来收益。5-shot 和它相比,图形类差约 2 到 10 分,文字标记差约 10 分。加了训练的那一版没有在这 6 张图上评过,所以不能直接放进来比。
还要注意:它的验证和测试图与训练图来自同一批原图,画法风格一致;而我的样例强制来自另一张原图。所以它是“固定类别、同一风格”下的上限,不是同一起跑线上的对手。它也说明了一点:在这个数据集上,100 来张图的全监督训练就能做到 95 以上,这个数据集本身对监督学习并不难。
学到的东西
- 预处理有时比换模型重要。去直线这一步让 OCR 定位召回从 11% 到 96%,换哪个 OCR 引擎都没有这么大的差别。
- “是不是符号”比“是哪个符号”好泛化。类无关检测器对新形状大体能检出,但训练集里没有的外形(圆形)会整类漏掉。
- 多给几个样例是最便宜的改进。端到端从 1-shot 到 5-shot,micro +7.5,macro +12.4,不需要任何训练。
- 拒识是最弱的一环。不拒识时精确率只有 50.5,拒识又会误杀 D 这种相似度天然偏低的类,单靠阈值解决不了。
- 评测口径决定难度。同源测试和跨图纸测试是两回事,比较之前要先确认测试图有没有出现在对方的训练集里。
- 标注本身有噪声。检测器 19 个误检里 15 个是漏标,还有 K2、Mpy 的错标。数字是在这个上限下得到的。
也要说明这次实验的局限:只有一个数据集、一种图纸风格;测试集只有 30 张图,留出类每类 5 到 11 个实例,置信区间很宽(例如 37/42 的 95% 区间约为 74% 到 96%);跨项目、跨设计院的泛化完全没测;部分计时是在机器负载很高时测的。
下一步
- 检测器补形状覆盖:在真实图纸背景上贴随机线稿图元(圆、三角、菱形、方框加字母),把漏标符号设成忽略区域,目标是不再整类漏掉圆形符号。
- 交互闭环:第一次检出后让用户确认几个结果,直接加进样例库。从 1 个样例到 5 个样例的提升说明,这比继续调模型划算。
- 混合方案:常用符号用少量标注做监督训练,one-shot 只负责新出现的符号。
- 更好的 D 表征:多样例覆盖竖向拱形,或者做小规模度量学习,让 D 和背景文字分开。
- 换图纸验证:在不同来源、不同画法的图纸上测,看这套流程离开这个数据集之后还剩多少。